Qu'est-ce qu'un PC pour LLM local ?
Un PC pour exécuter des modèles de langage (LLM) localement est un ordinateur suffisamment puissant pour faire fonctionner des intelligences artificielles génératives directement sur votre bureau, sans dépendre du cloud. Cela offre des avantages majeurs en termes de confidentialité des données, de latence réduite et de coûts opérationnels à long terme. Le choix du bon matériel est crucial, car les LLM sont extrêmement gourmands en ressources, nécessitant une combinaison optimale de puissance de traitement, de mémoire vive (RAM) et de stockage rapide.
Spécifications techniques clés
Pour un déploiement efficace de LLM, plusieurs composants sont primordiaux :
-
Processeur (CPU) : Un CPU multi-cœurs avec une fréquence élevée est essentiel, surtout pour les modèles plus petits ou les étapes de prétraitement. Les cœurs Performance (P-cores) des processeurs Intel Core modernes sont particulièrement adaptés.
-
Mémoire vive (RAM) : C'est l'un des facteurs les plus limitants. Pour exécuter des modèles de taille moyenne (7B-13B paramètres) de manière acceptable, 16 Go de RAM sont un minimum. Pour des modèles plus grands ou un multitâche fluide, 32 Go ou plus sont recommandés.
-
Stockage (SSD) : Un SSD NVMe rapide est indispensable pour charger rapidement les poids du modèle (qui peuvent faire plusieurs gigaoctets) et pour un échange de données fluide avec la RAM.
-
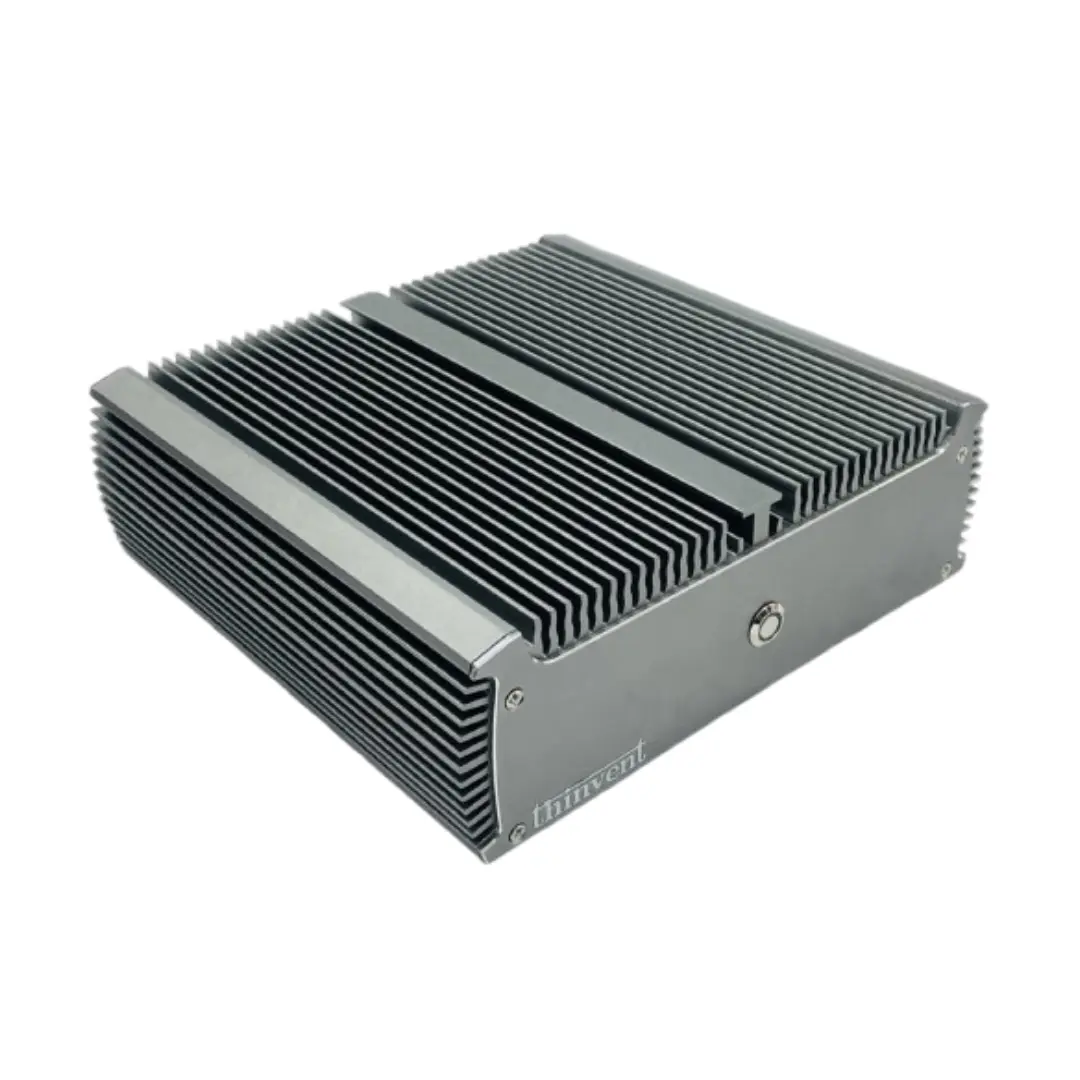
Refroidissement : Une charge de travail LLM peut solliciter le CPU à 100% pendant de longues périodes. Un système de refroidissement robuste et fiable est nécessaire pour maintenir des performances stables et éviter les ralentissements thermiques.
Cas d'utilisation et applications
Le déploiement local de LLM ouvre la voie à de nombreuses applications professionnelles :
-
Développement et Prototypage AI : Test et raffinement de modèles dans un environnement sécurisé et contrôlé.
-
Analyse de Documents Confidentiels : Traitement de données sensibles (juridiques, médicales, R&D) sans risque de fuite vers des serveurs externes.
-
Assistants IA Personnalisés : Création d'assistants dédiés à des workflows métier spécifiques, intégrés aux outils internes.
-
Bancs d'essai et Éducation : Environnement idéal pour apprendre le fonctionnement des LLM et expérimenter avec différents modèles open-source comme Llama 2, Mistral ou Gemma.
Comparatif des architectures pour LLM
Le choix entre un processeur ARM et x86 (Intel) dépend de vos besoins précis :
| Critère | Architecture ARM (ex : Cortex A55) | Architecture x86 (ex : Intel Core i5) | Recommandation pour les LLM |
|---|---|---|---|
| Puissance de calcul | Adaptée aux tâches légères, basse consommation. | Puissance brute bien supérieure, idéale pour le calcul intensif. | x86 est fortement recommandé pour la charge de travail LLM. |
| Compatibilité logicielle | Limitée, souvent sous Linux embarqué. | Large compatibilité avec tous les frameworks AI (Ollama, LM Studio, etc.) et OS. | x86 offre une compatibilité universelle. |
| Mémoire (RAM) | Généralement limitée (2 Go à 4 Go dans nos exemples). | Configurations disponibles avec 16 Go, 32 Go ou plus. | x86 permet les configurations >16 Go nécessaires. |
| Cas d'usage idéal | Client léger, affichage digital, IoT. | Déploiement local de LLM, stations de travail, serveurs edge. | Le x86 est l'architecture de choix. |
Solutions Thinvent pour le déploiement de LLM
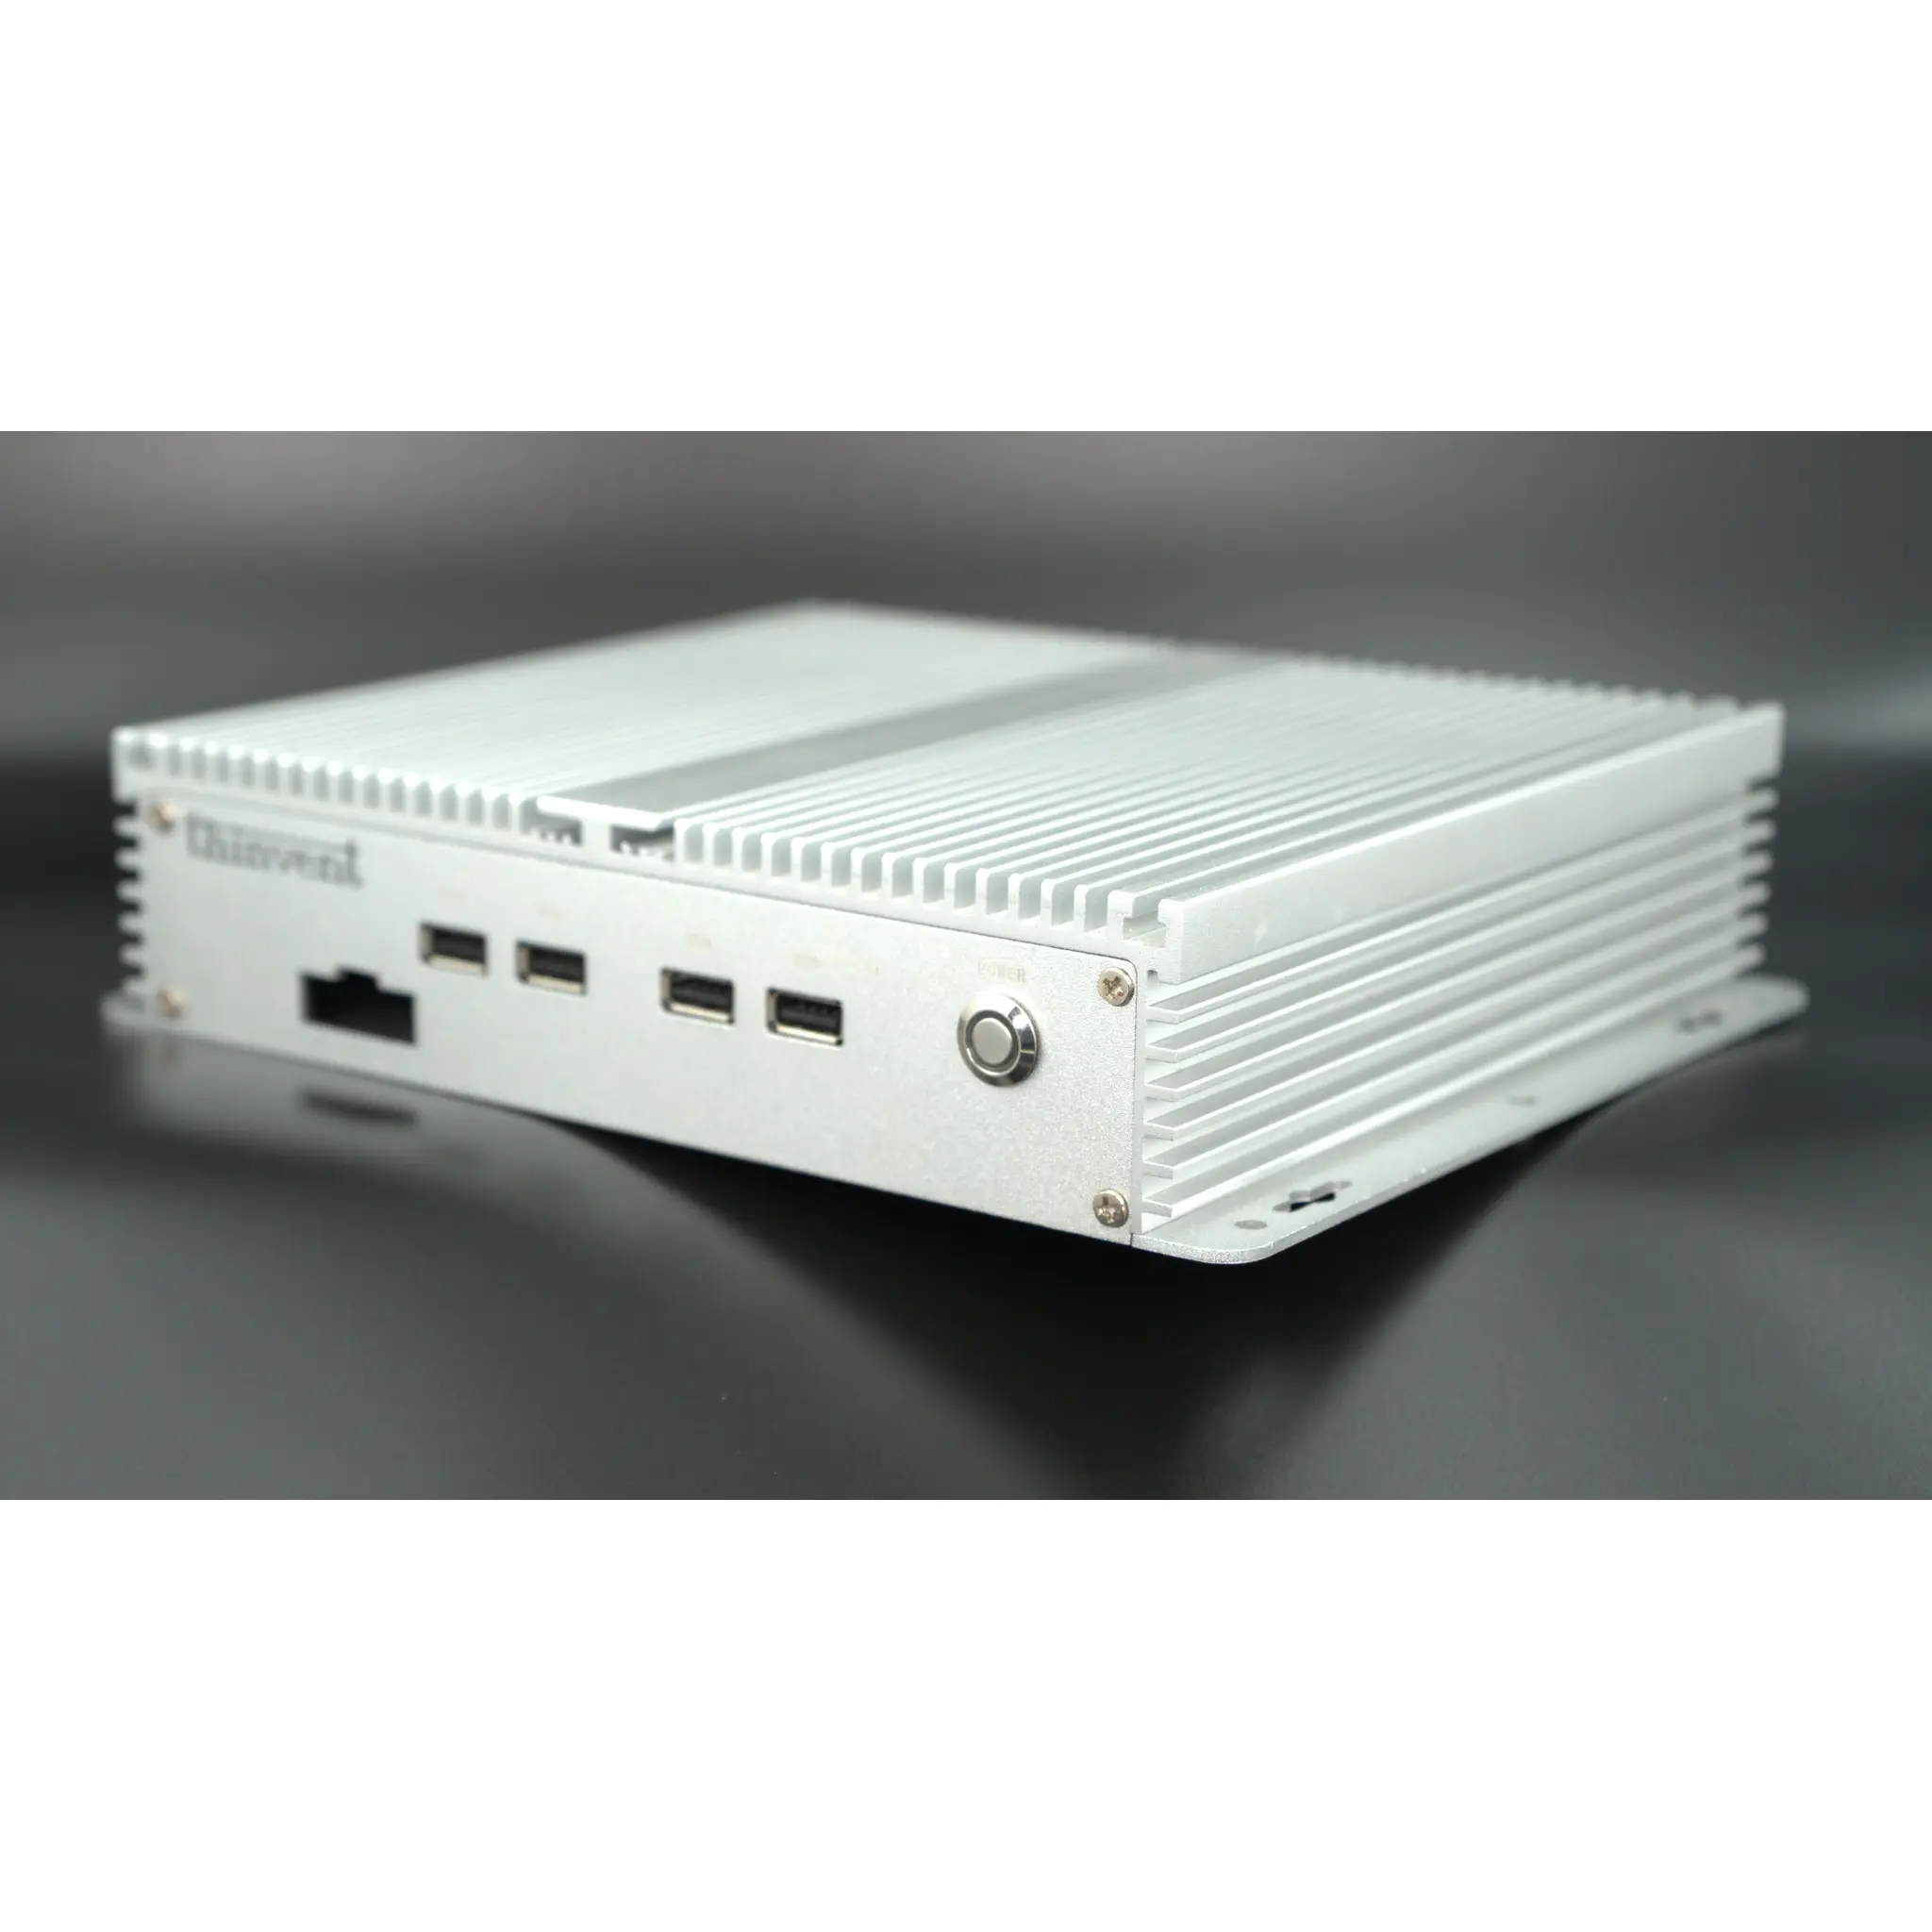
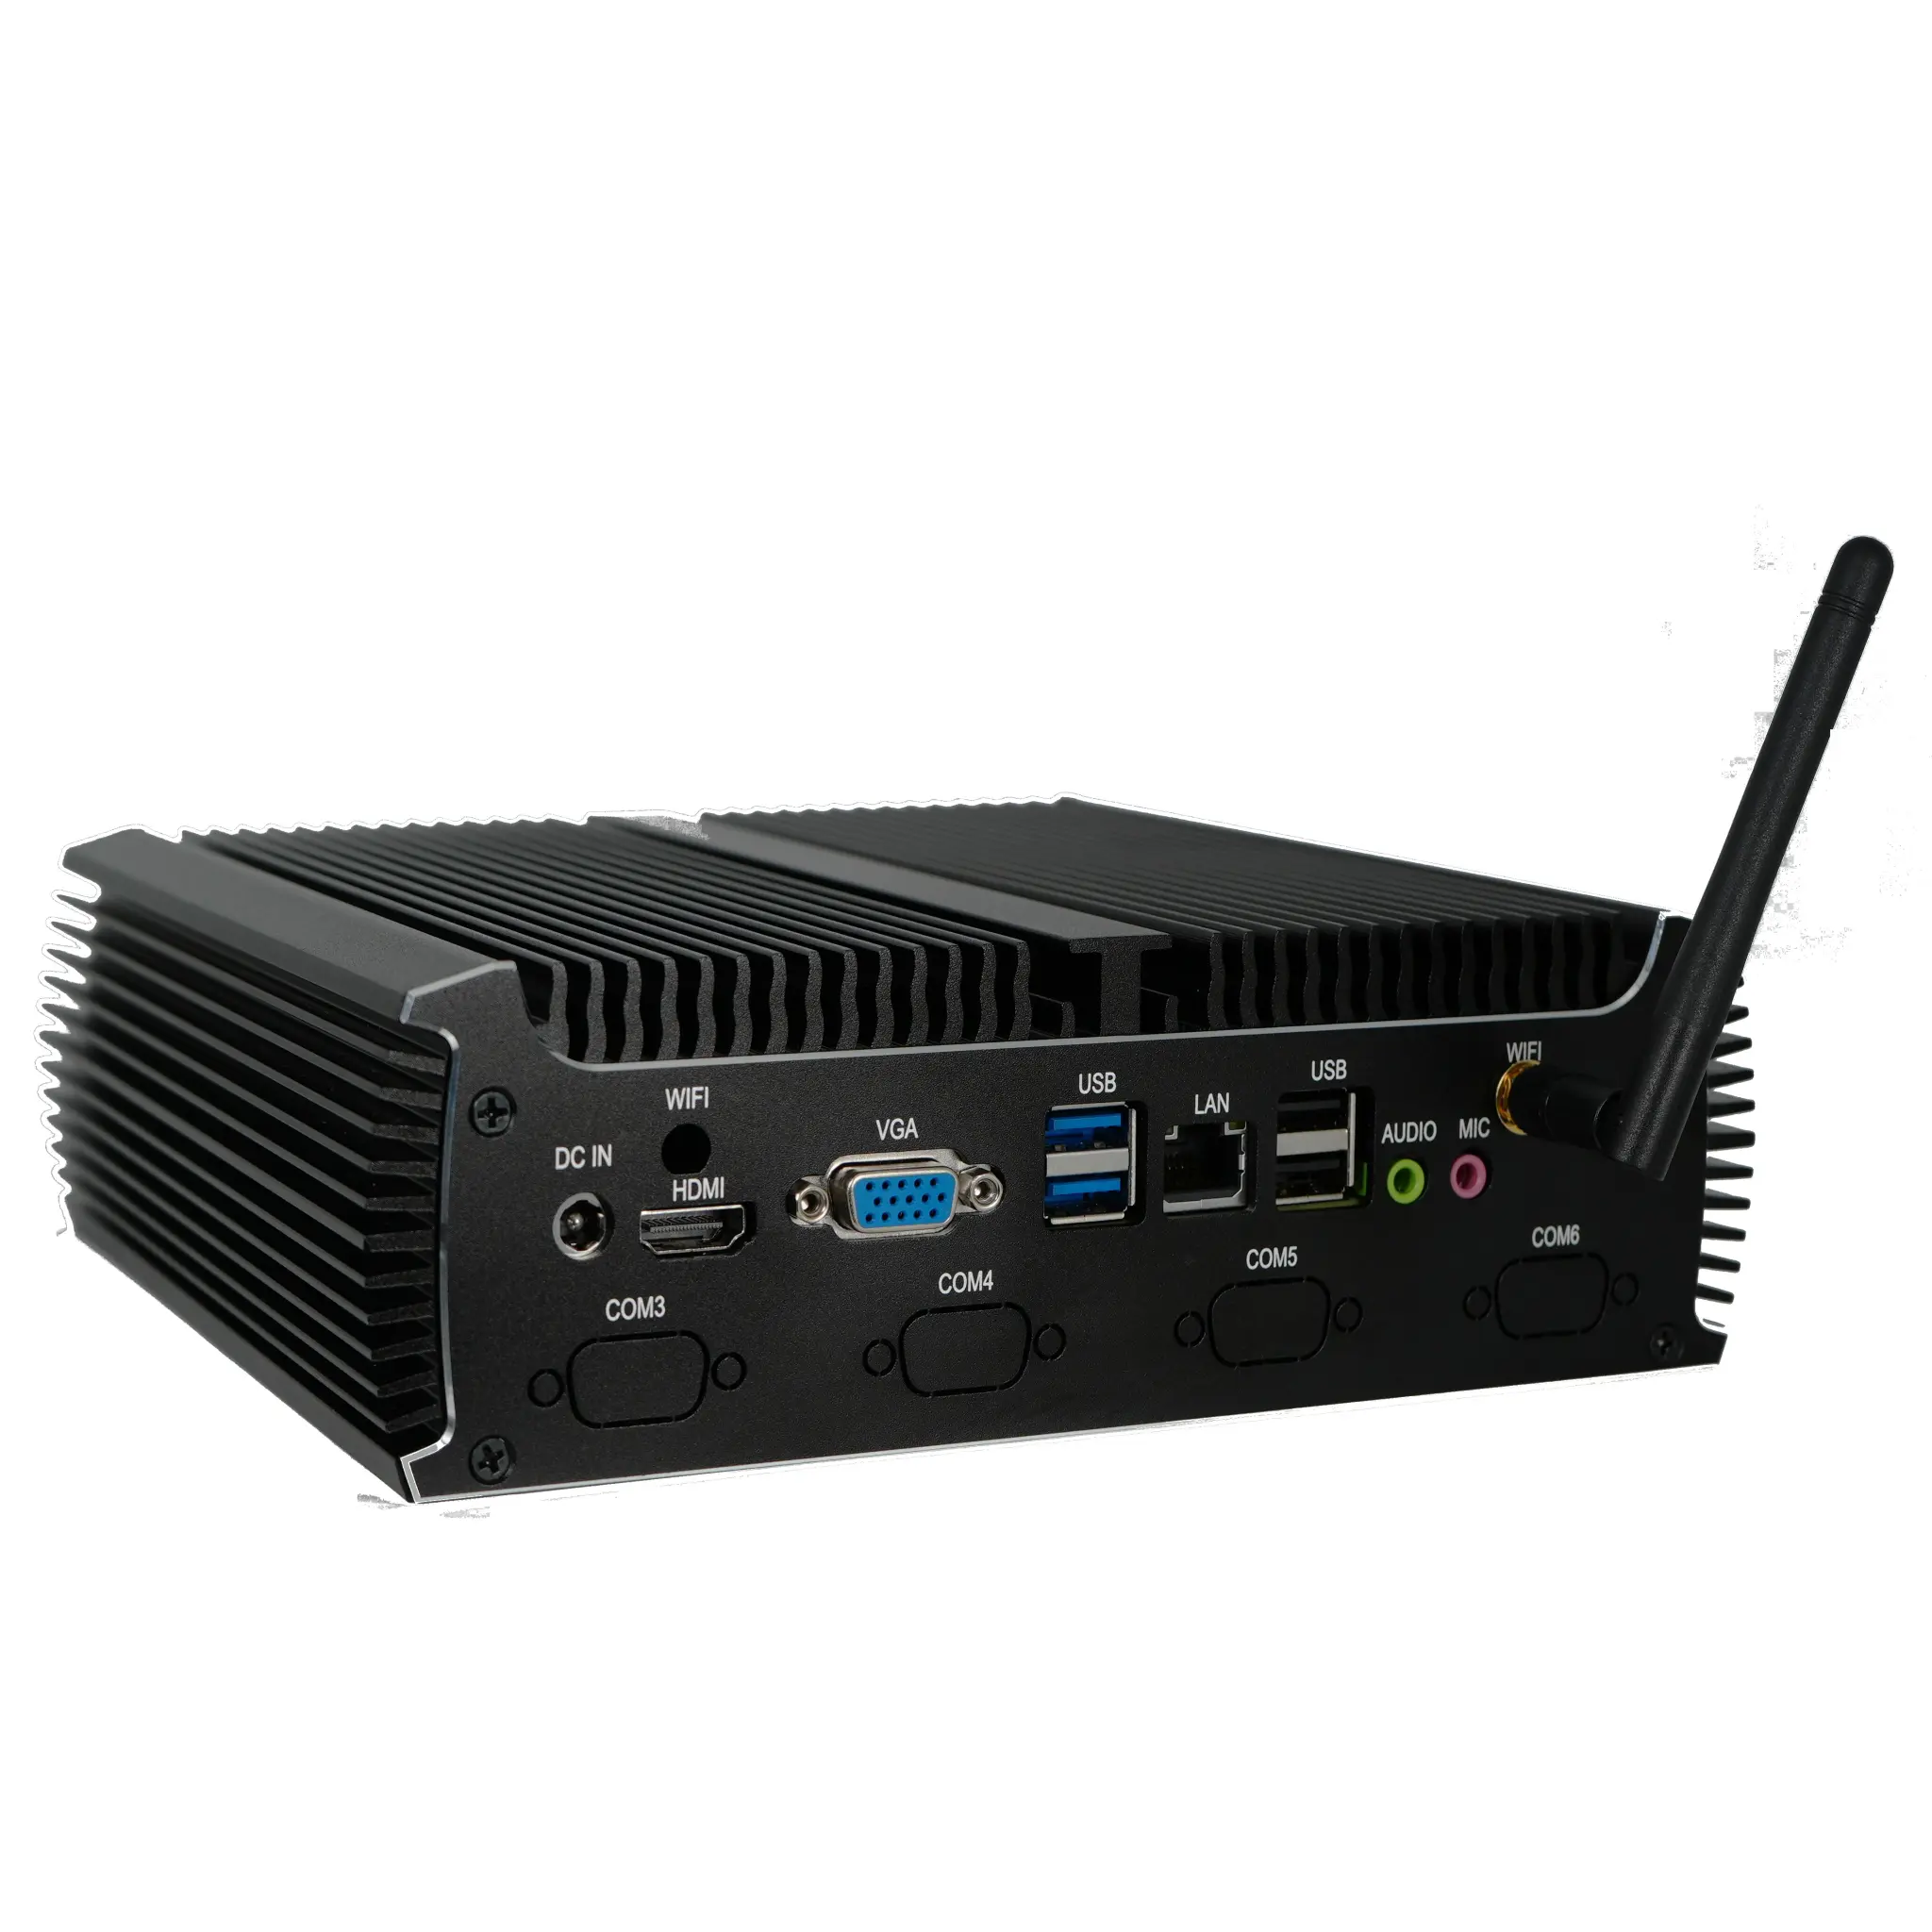
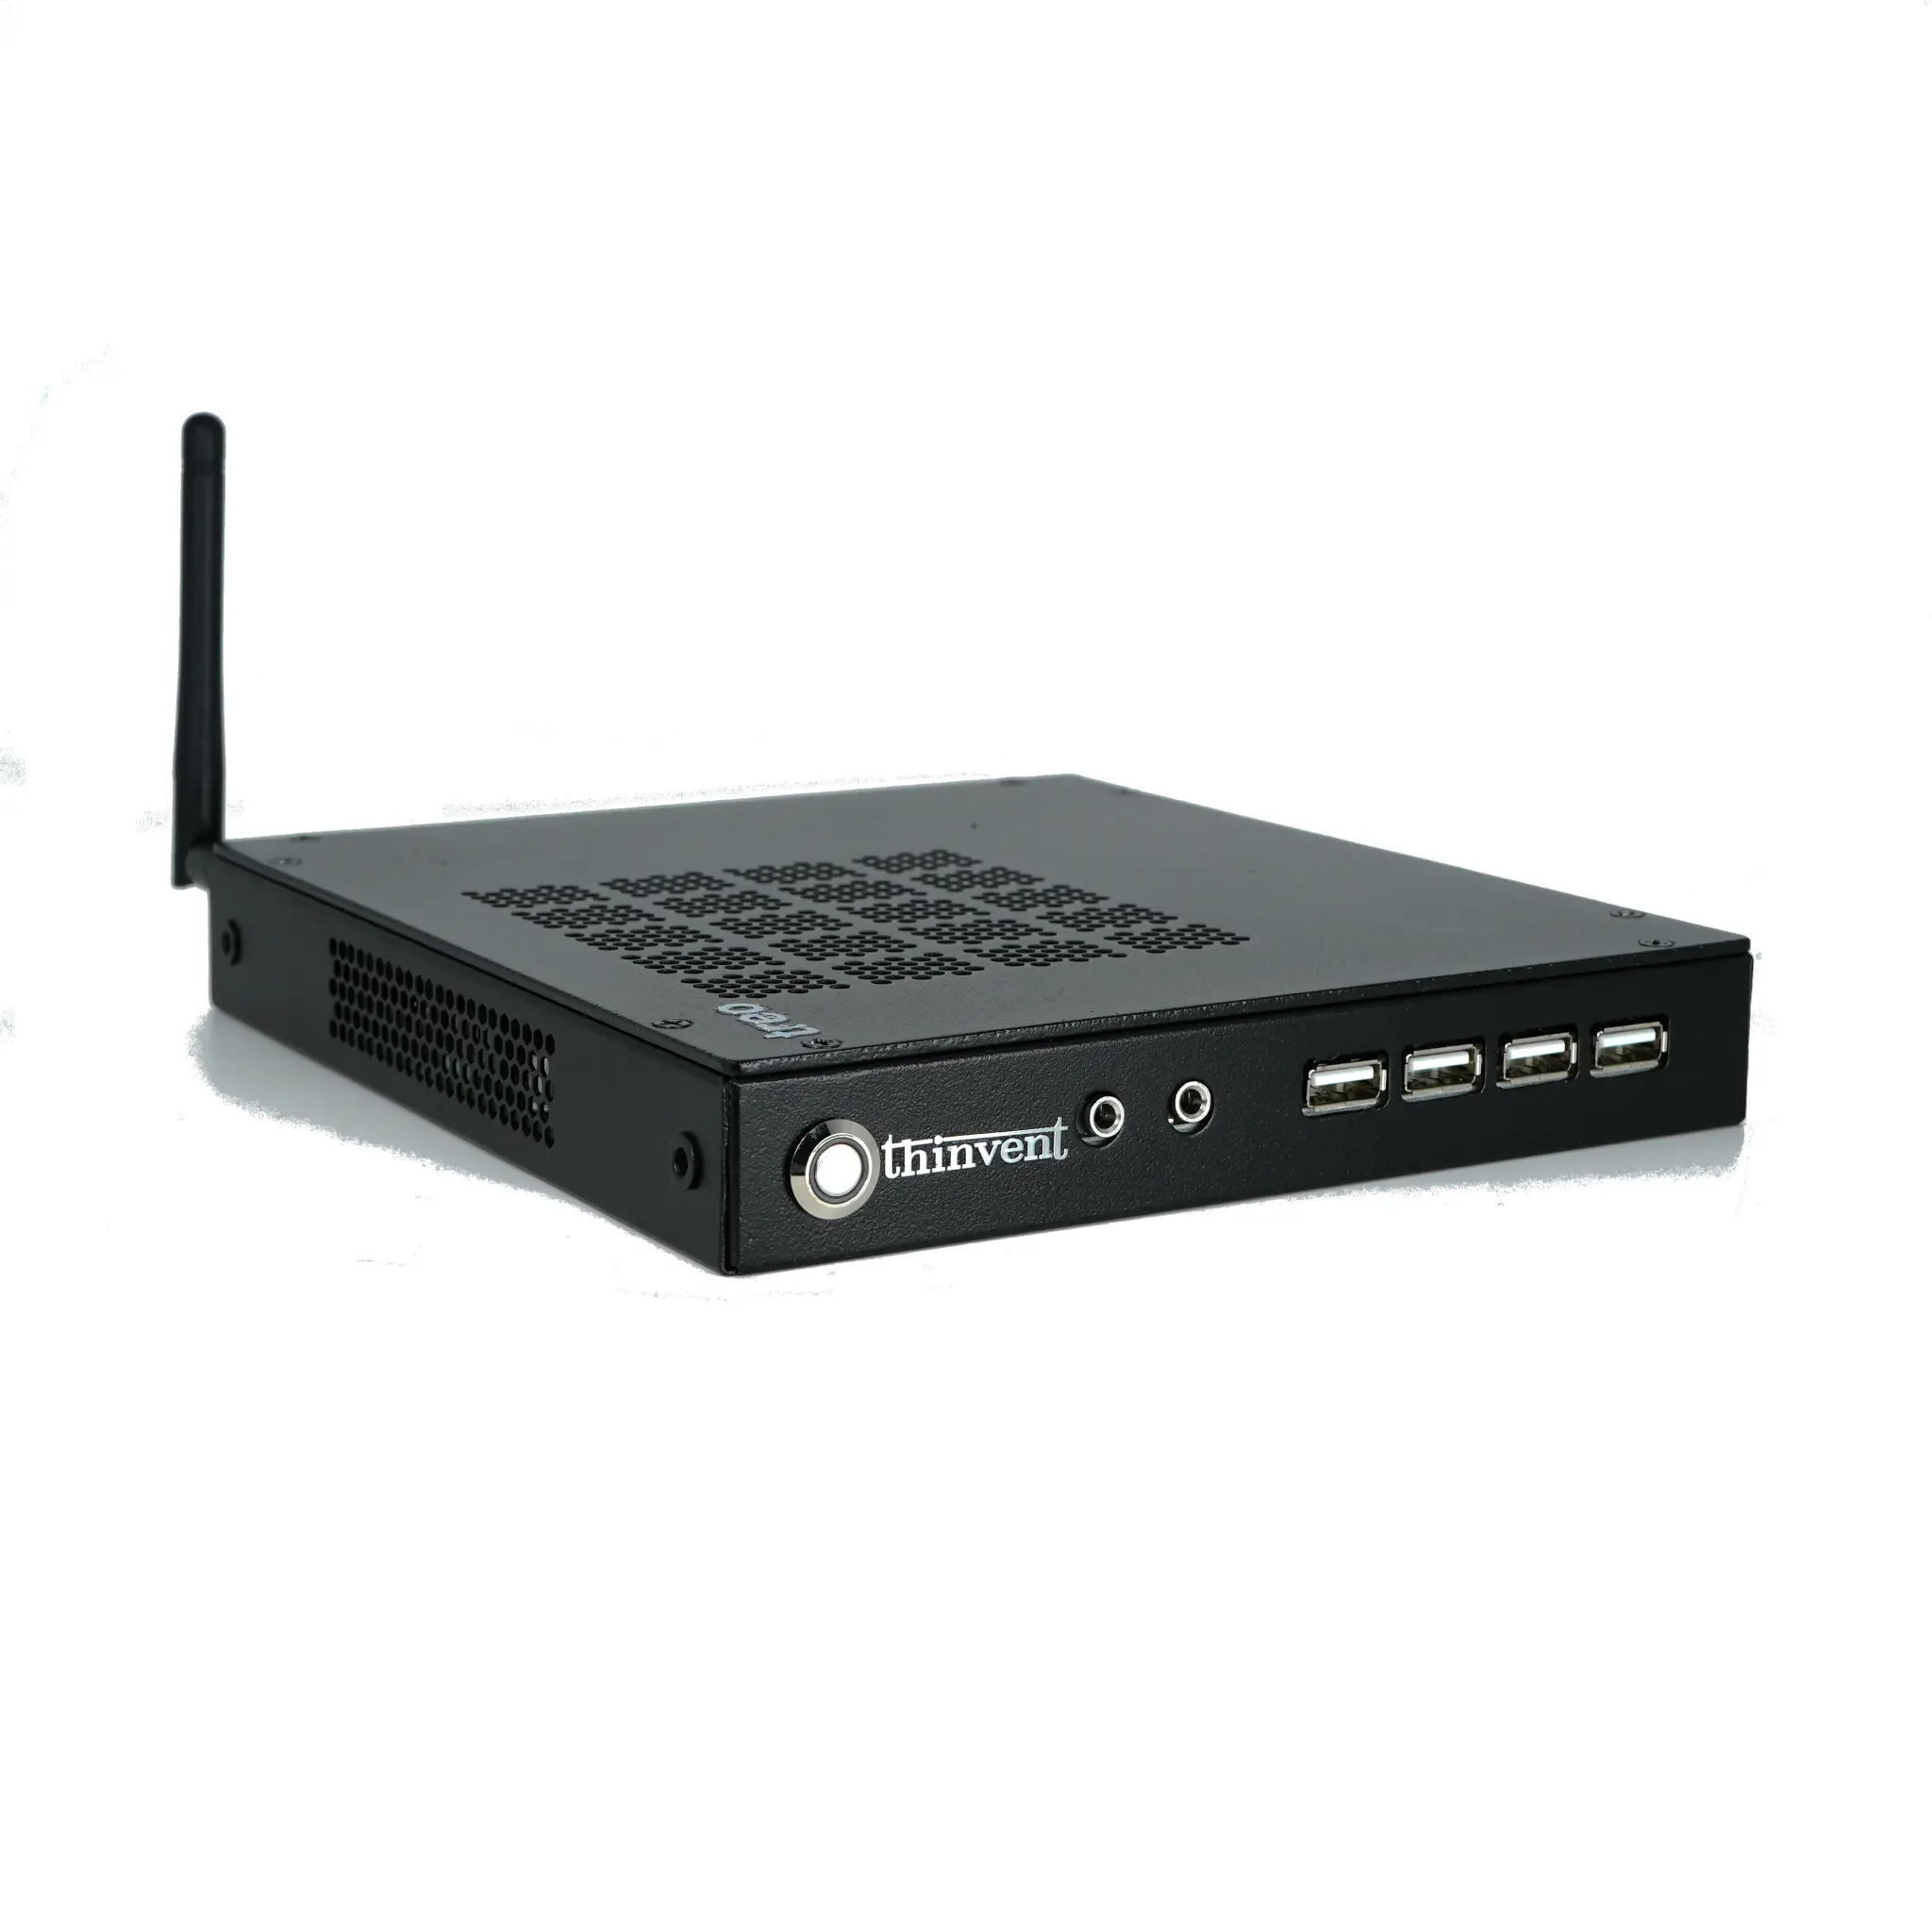
Thinvent propose une gamme de PC industriels et mini-PC basés sur l'architecture x86 d'Intel, conçus pour répondre aux exigences du traitement local d'IA.
Nos PC industriels de la série IPC, comme l'**IPC5 équ