Executar modelos de linguagem grandes (LLMs) localmente exige hardware específico que equilibre poder de processamento, memória e eficiência. A escolha do PC ideal depende do tamanho e complexidade do modelo que se pretende executar, bem como dos requisitos de velocidade de inferência. Para modelos menores ou tarefas de desenvolvimento e teste, unidades com processadores eficientes e RAM adequada podem ser suficientes. Para modelos maiores e uso em produção, são necessários processadores de alto desempenho com múltiplos núcleos, quantidades generosas de RAM de alta velocidade e armazenamento SSD rápido.
As especificações técnicas mais críticas para a execução local de LLMs incluem:
-
CPU (Processador): Núcleos e frequência são fundamentais. Processadores Intel Core i5/i7 de gerações recentes, com alto número de núcleos (físicos e lógicos) e frequências turbo elevadas, oferecem o melhor desempenho para cargas de trabalho de IA.
-
RAM (Memória): A quantidade de RAM é muitas vezes o fator limitante. Modelos de 7B a 13B de parâmetros podem exigir de 8GB a 16GB. Modelos maiores (30B+) podem necessitar de 32GB ou mais para operar eficientemente.
-
Armazenamento: Um SSD NVMe rápido é essencial para carregar rapidamente os pesos do modelo (que podem ter dezenas de gigabytes) na memória.
-
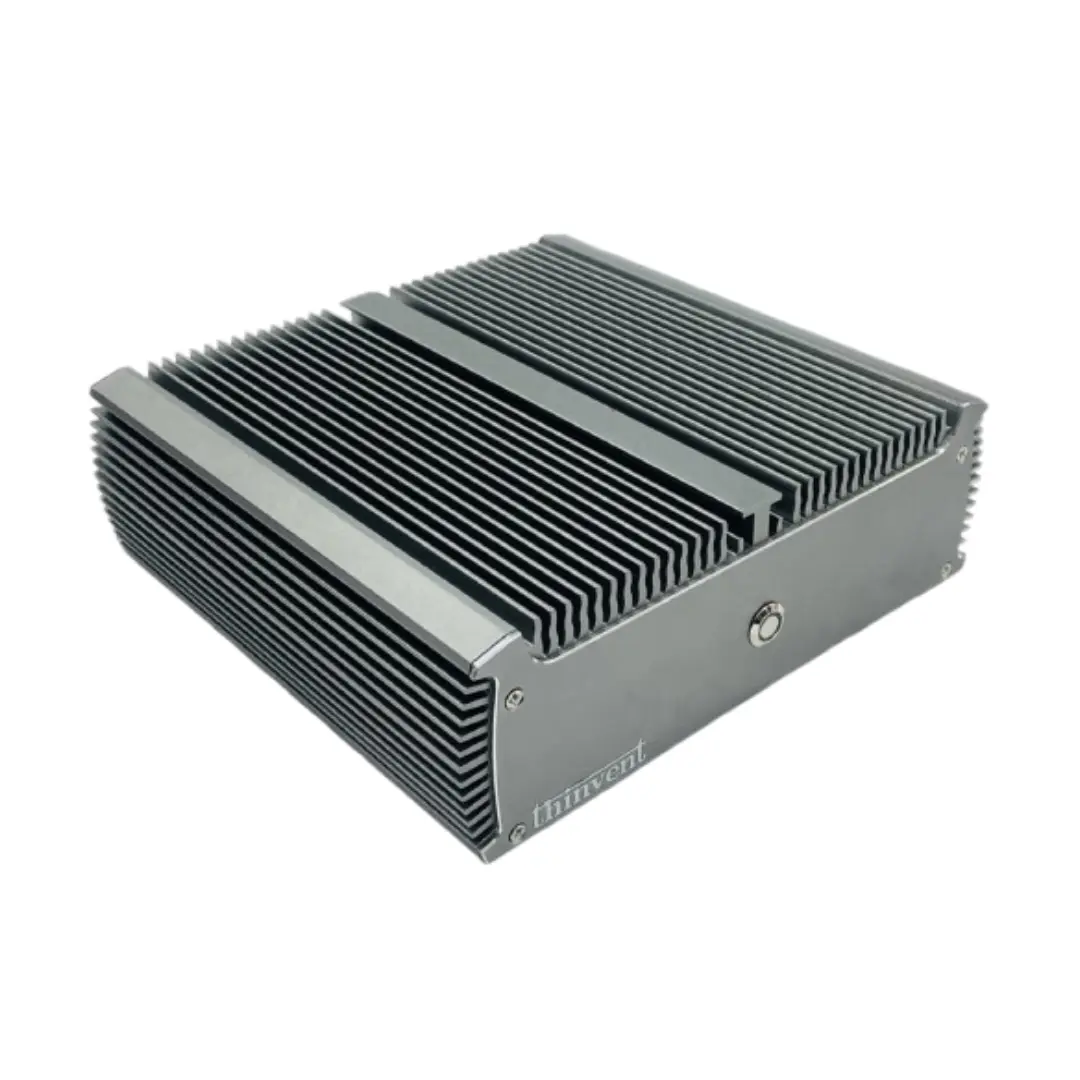
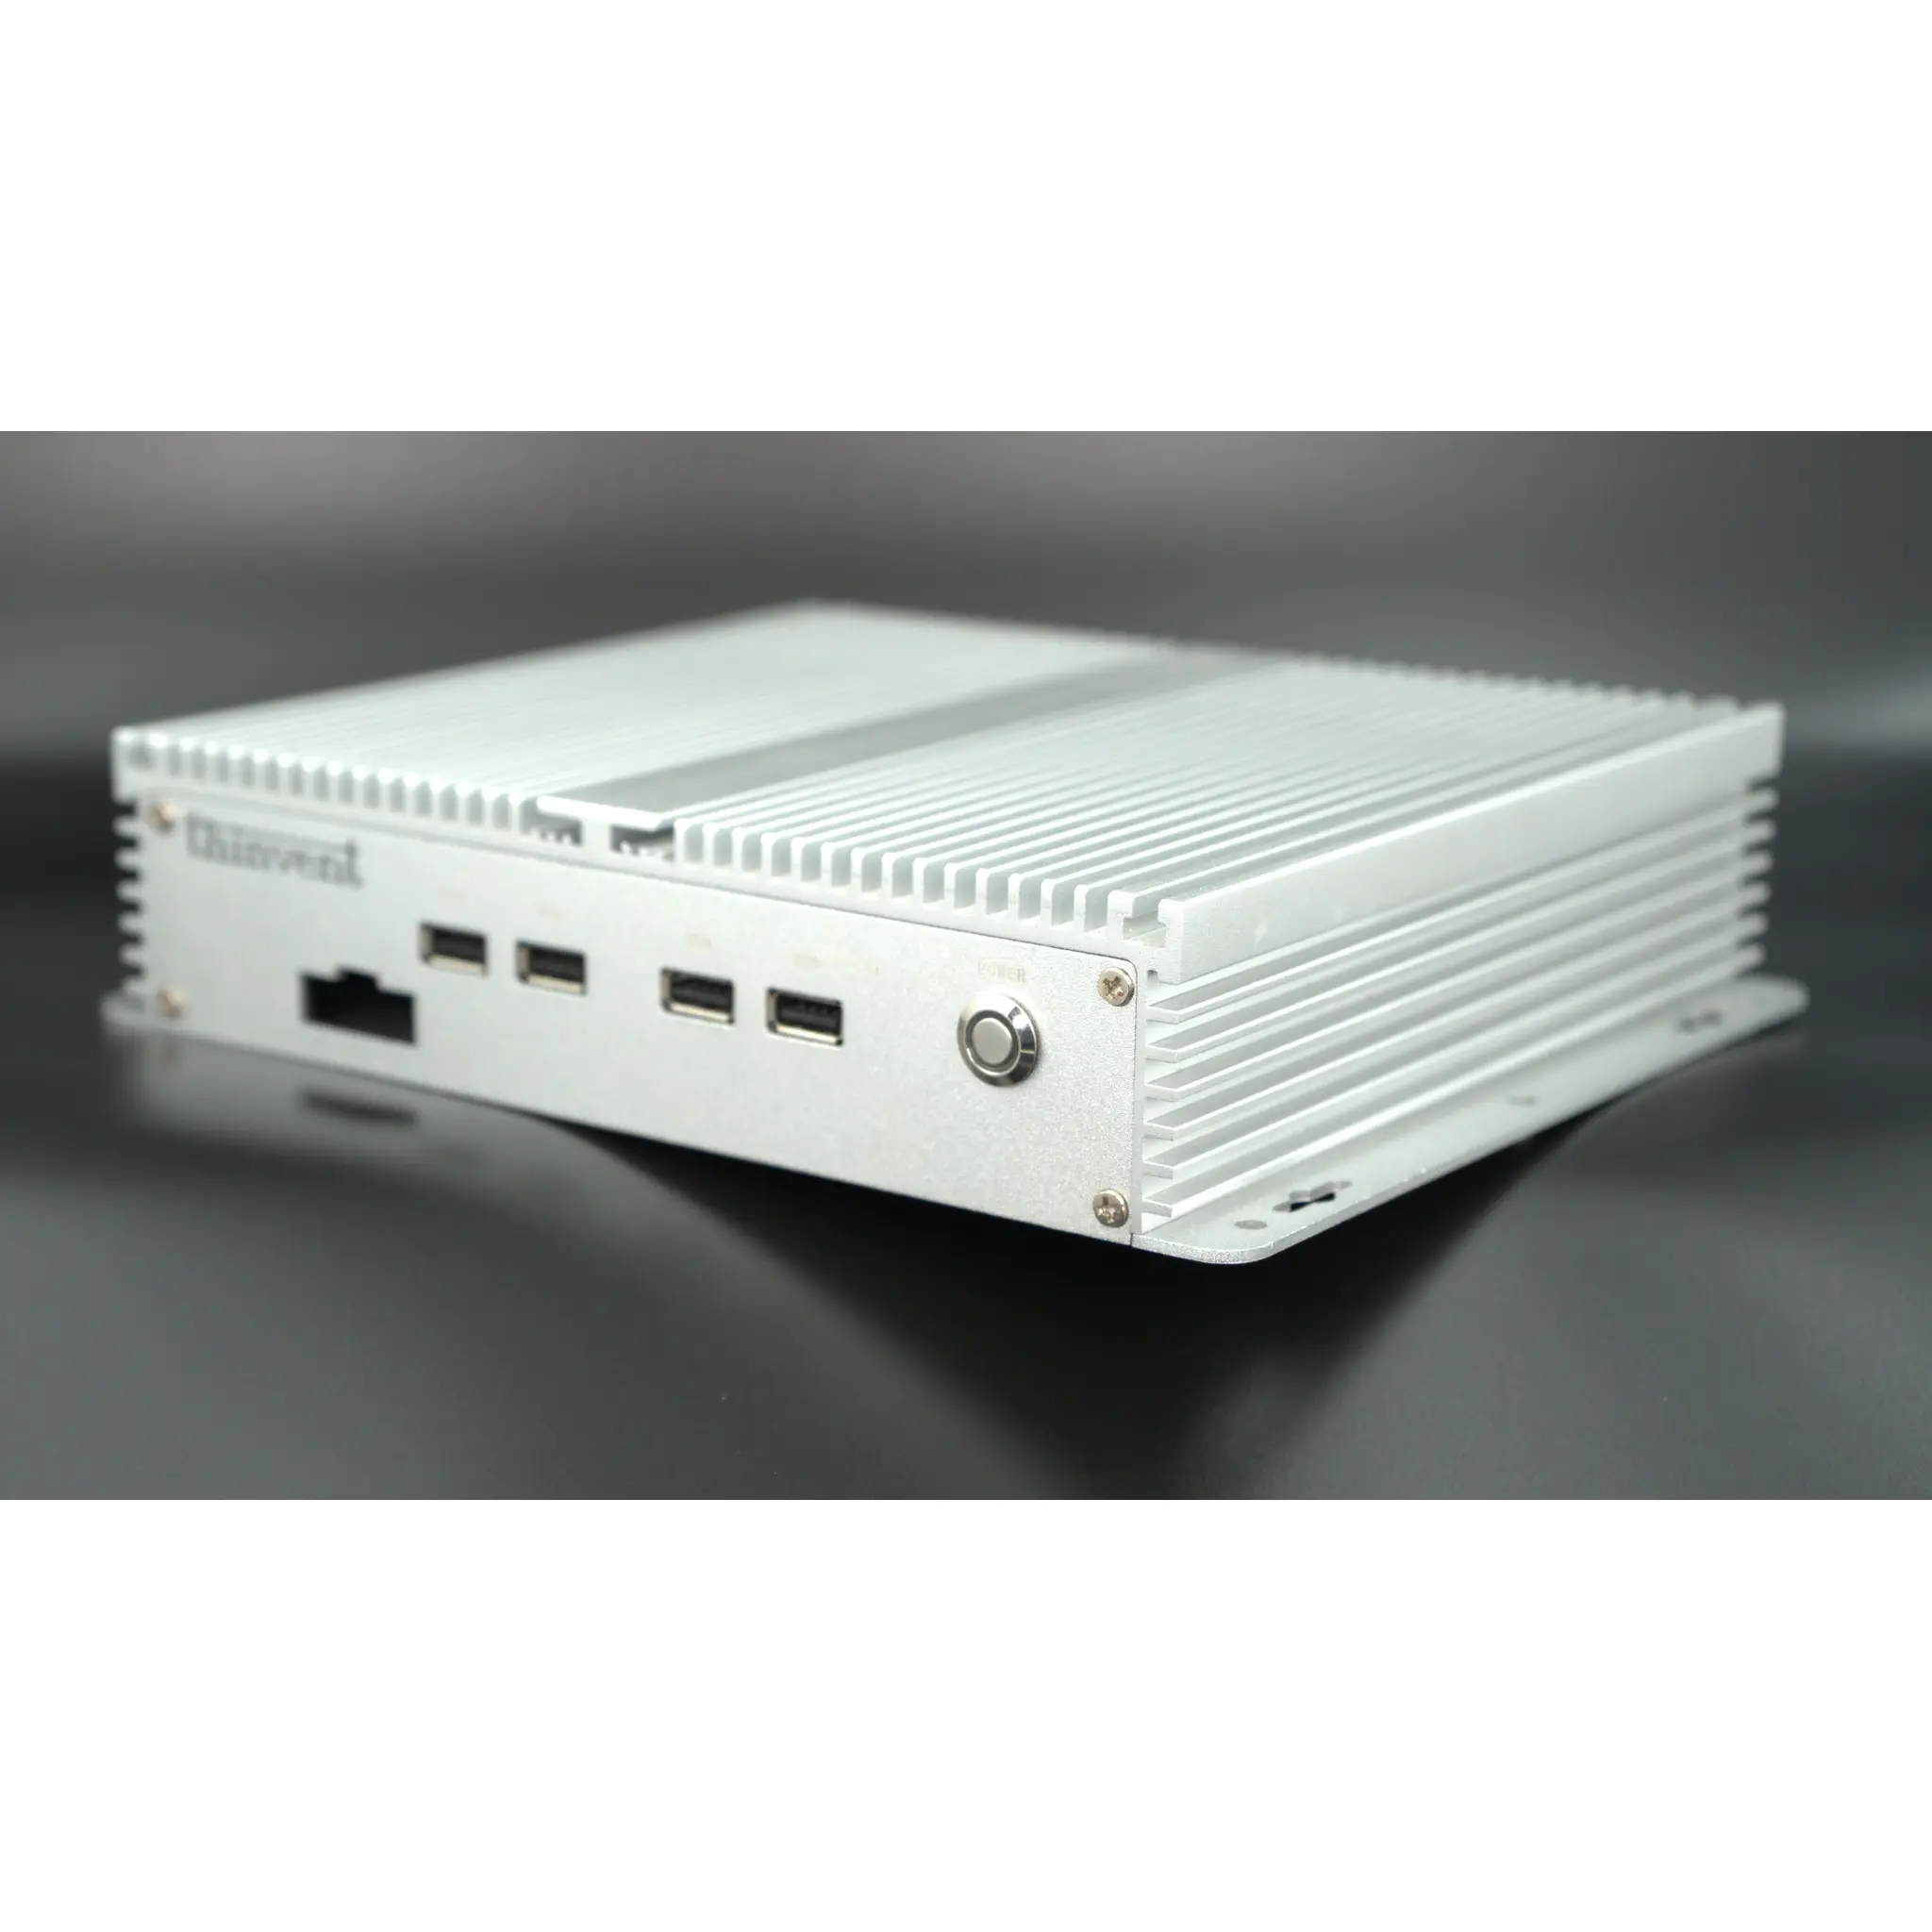
Resfriamento: Cargas de trabalho de LLM podem estressar o CPU por longos períodos. Um design com dissipação térmica robusta e operação silenciosa é crucial para sustentabilidade.
Os principais casos de uso para PCs de alto desempenho executando LLMs localmente incluem:
-
Desenvolvimento e Prototipagem de IA: Testar e ajustar modelos de código aberto como Llama 2, Mistral ou modelos personalizados em um ambiente privado.
-
Análise de Dados e Pesquisa: Processar documentos confidenciais, realizar análise de sentimentos ou pesquisa acadêmica sem depender de APIs na nuvem.
-
Assistentes de Produtividade Locais: Executar assistentes de IA personalizados para automação de tarefas, redação ou suporte à decisão com total privacidade de dados.
-
Gateways e Hubs de IA: Servir como um nó local para inferência de modelos menores em uma rede corporativa ou em aplicações de borda (edge computing).
A tabela abaixo compara configurações típicas e sua adequação para diferentes cargas de trabalho de LLM:
| Configuração Alvo (CPU / RAM) | Adequado para Modelos | Casos de Uso Principais | Considerações |
|---|---|---|---|
| Entrada/Eficiente (e.g., Intel N100 / 4-8GB RAM) | Modelos muito pequenos (<3B) ou quantizados. | Experimentação básica, aprendizado. | Limitado a tarefas leves; pode usar quantização agressiva. |
| Médio/Equilibrado (e.g., Intel Core i3 / 8-16GB RAM) | Modelos de 7B a 13B parâmetros (quantizados). | Desenvolvimento, prototipagem, assistentes pessoais. | Bom equilíbrio entre custo e capacidade para muitos modelos populares. |
| Alto Desempenho (e.g., Intel Core i5/i7 / 16-32GB+ RAM) | Modelos de 13B a 30B+ parâmetros. | Pesquisa, análise de dados, inferência em produção para equipes pequenas. | Oferece velocidade e capacidade para a maioria das aplicações sérias de LLM local. |
Soluções Thinvent para LLMs Locais
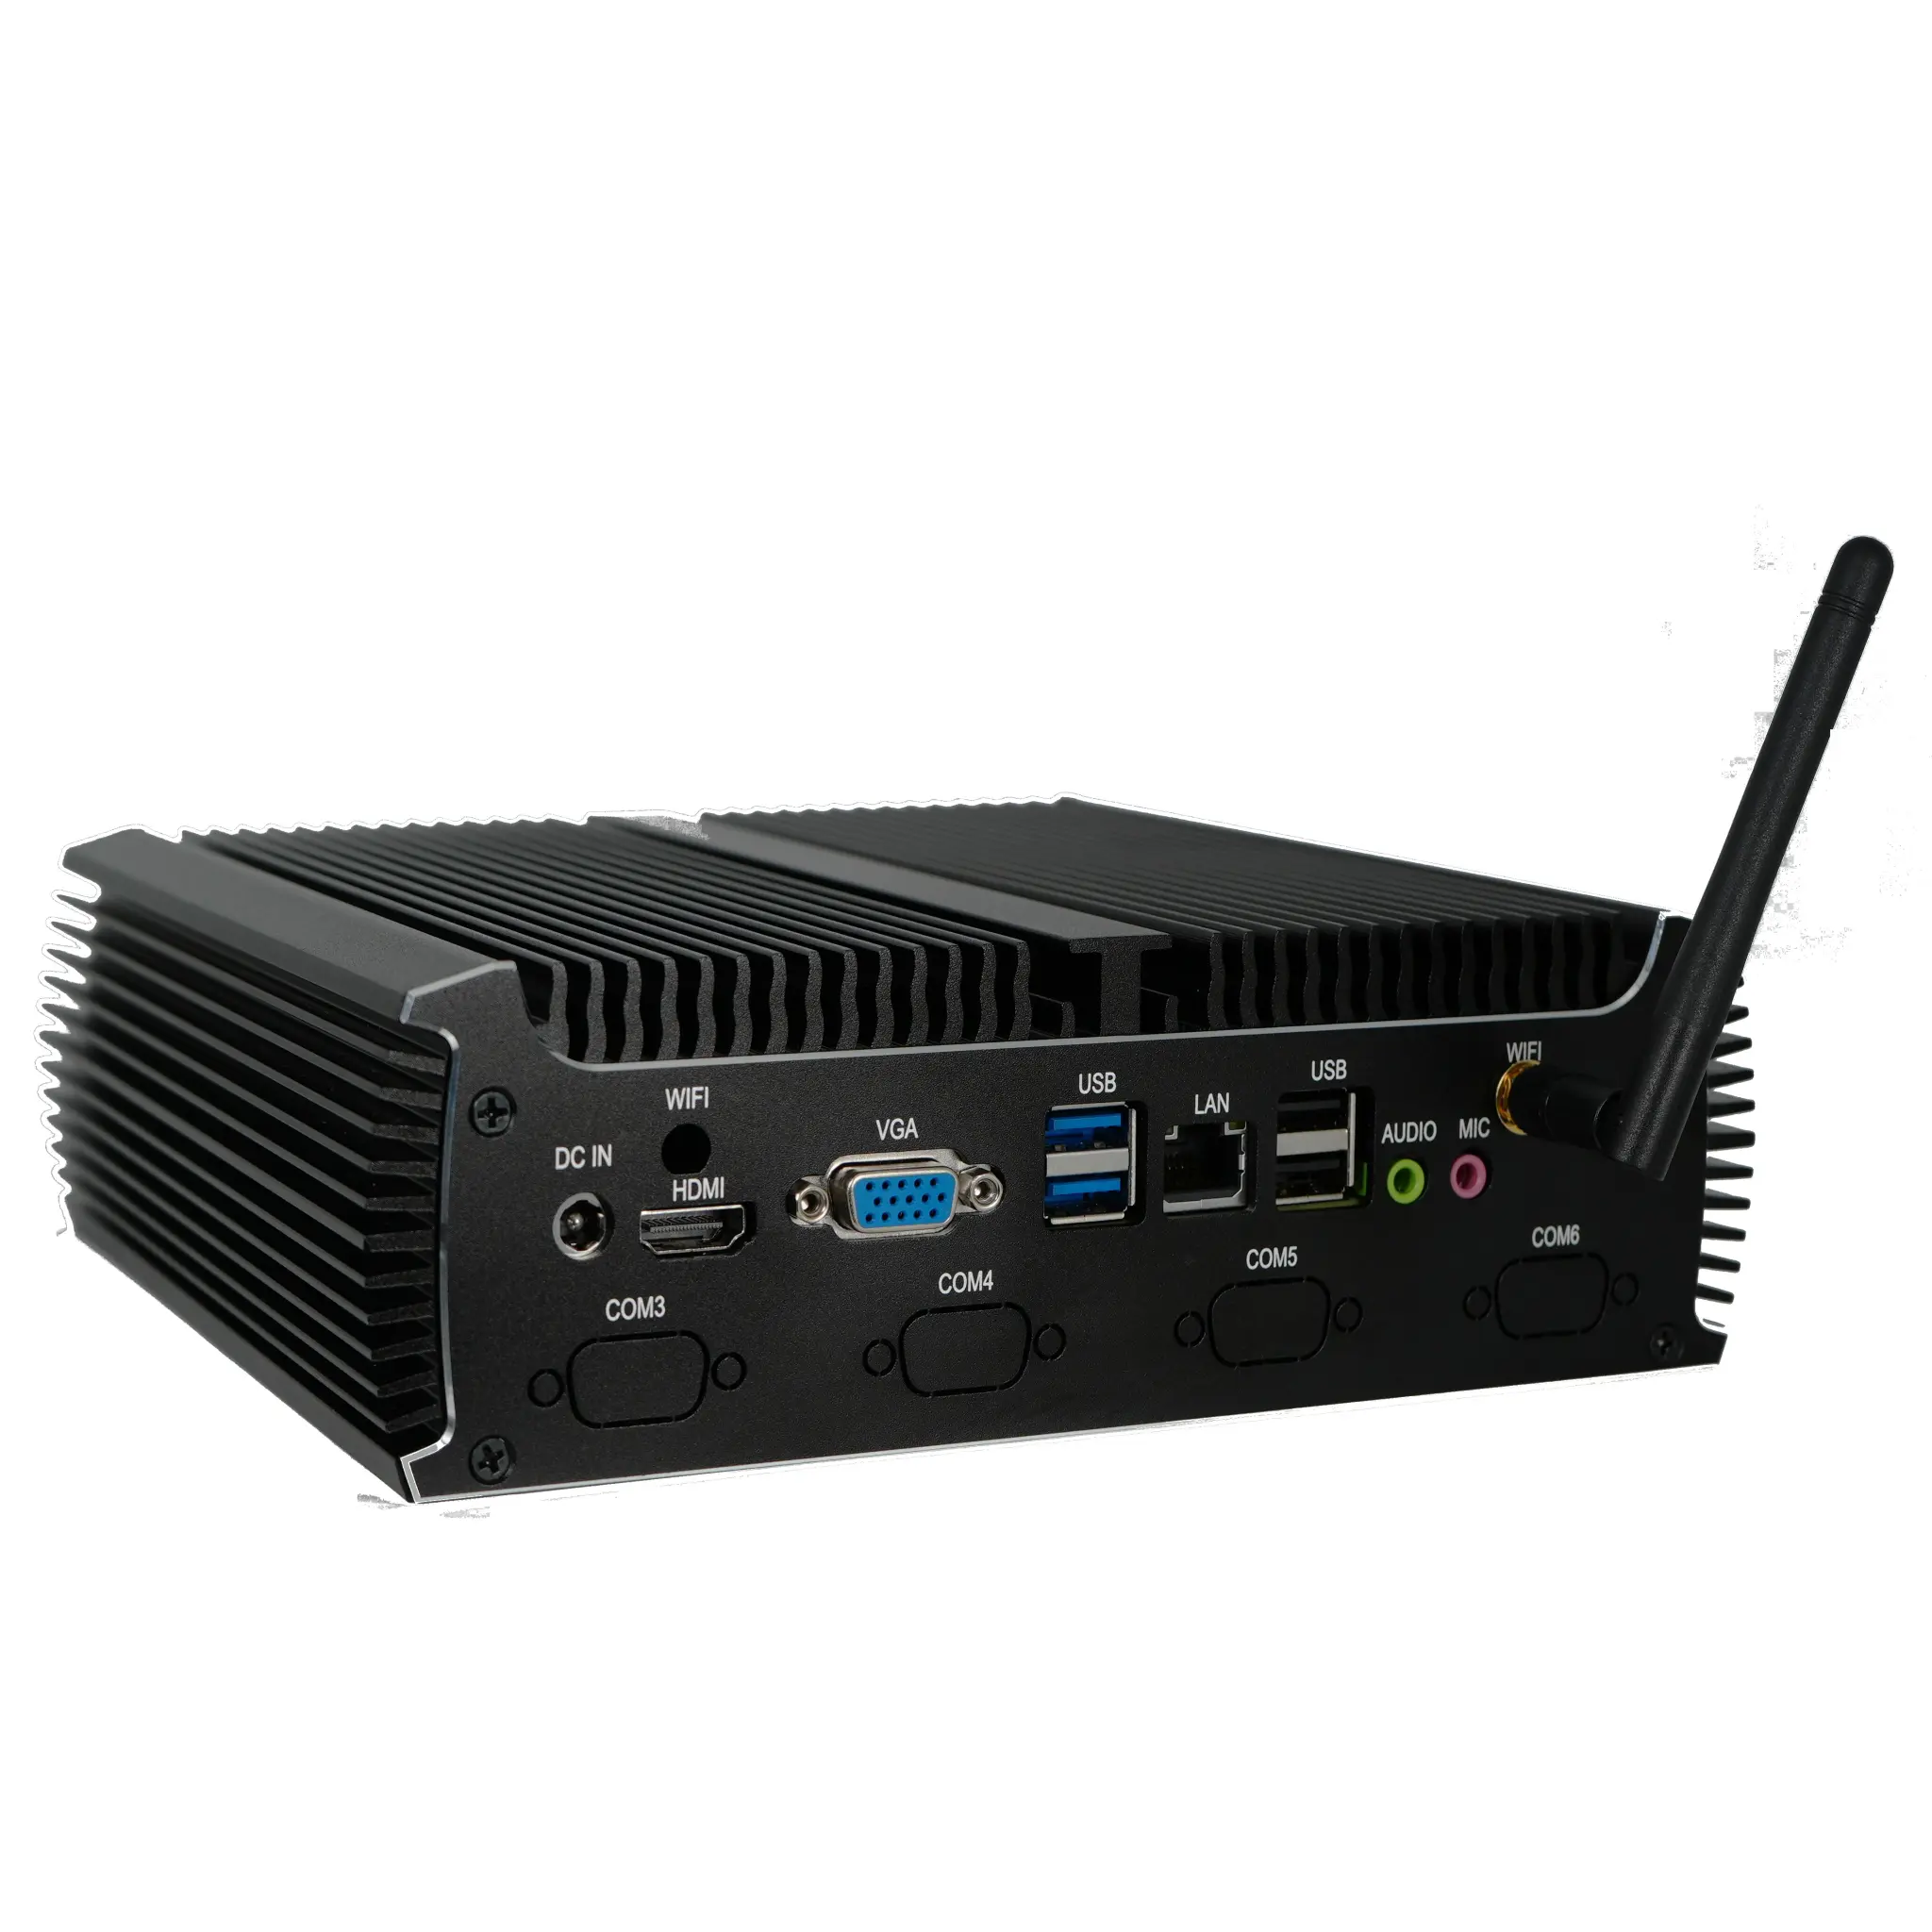
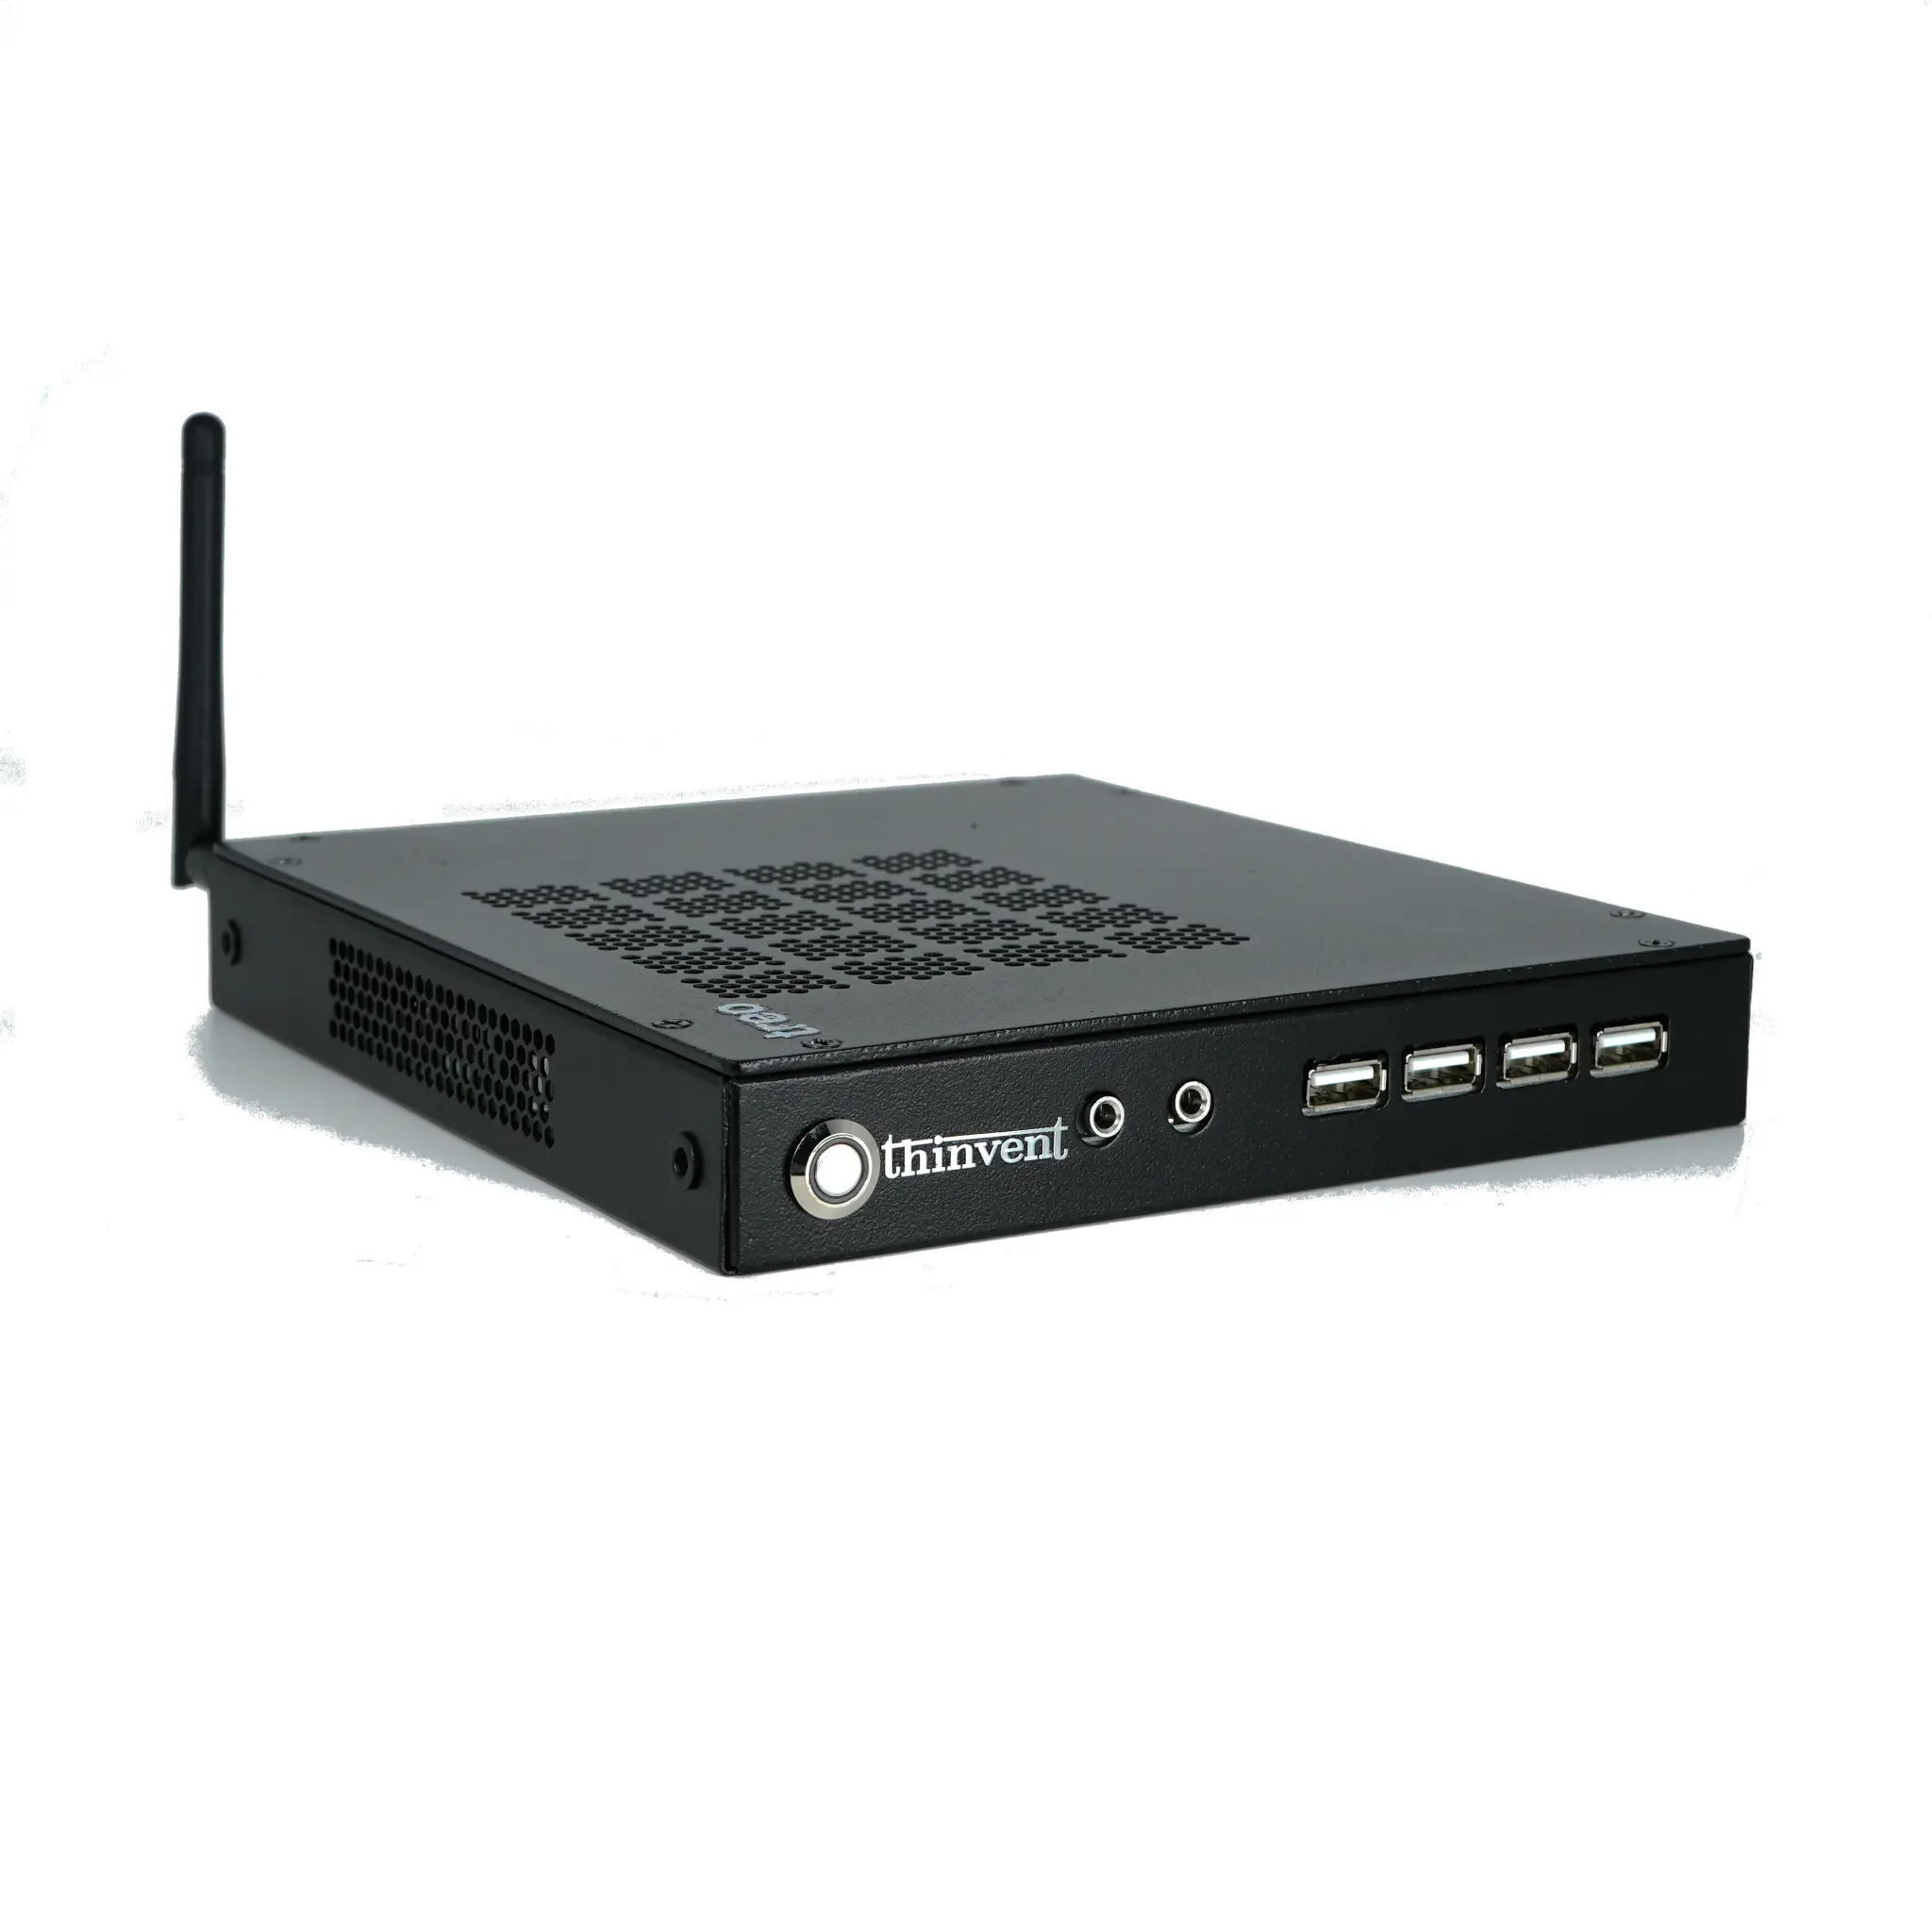
A Thinvent oferece uma gama de computadores industriais e mini PCs robustos, ideais para a implantação estável e confiável de LLMs em ambientes locais. Nossos sistemas com processadores Intel Core de 12ª e 14ª geração, como os das linhas IPC e Aero, fornecem a combinação poderosa de múltiplos núcleos, altas frequências de clock e suporte a memória DDR4, necessária para carreg